AgenticRAG · Evidence Service
专注成为证据服务
把分散知识转化为 Agent 可调用、可追溯、可审计的证据服务。边界清晰,因此可以嵌入现有智能体平台、业务系统或行业方案,无需推翻既有技术体系。
- 文档导入、统一解析、语义切块、向量化
- 索引构建、混合检索、知识编译与证据返回
- REST API 对外,不把应用锁定在某一种大模型上
随着大模型走向企业核心业务,智能体落地的关键正在从模型能力转向知识的稳定接入、准确检索与可信引用。
企业内部同时存在
PDF、Word、Excel、数据库记录和行业资料,传统方案容易重复建设、缺少出处且更新不及时。
把分散知识转化为 Agent 可调用、可追溯、可审计的证据服务。边界清晰,因此可以嵌入现有智能体平台、业务系统或行业方案,无需推翻既有技术体系。
AgenticRAG 不替代上层 Agent 的问题理解、任务规划和最终表达。它只负责把知识侧做扎实——检索拿到的每一份证据都可回溯,让上层应用放心地组织回答。
统一解析异构资料,构建可维护的索引与 Wiki 结构,按需返回带出处的证据单元。
负责理解用户问题、规划任务步骤、调用工具,并基于证据组织最终回答。
两端通过稳定的 API 契约协作,任一侧都可以独立演进、独立替换。
文件进入系统后,经统一解析、切块、Embedding 与索引写入,成为可被检索的知识单元;
检索侧再把命中的来源、正文、分数与 Metadata 组装为 evidence
cards 交还给上层。
文件新增、更新与删除均可触发同步,源目录持续跟随业务变化。
异构格式归一为结构化文本,元数据同步抽取,由 Worker 后台编排。
按语义边界切分而非定长硬切,让每个知识单元自身语义完整。
写入 Embedding 向量,云端兼容接口与本地 vLLM 均可接入。
向量索引与关键词索引同时就绪,为混合检索准备好双路命中。
同一个知识单元在三层之间逐级富化:切片层保留原文定位,编译层挂上 Wiki 与 Claim 归属,检索层再补齐分数与 Metadata。
从总览到 Wiki 编译,每一个界面都围绕同一件事设计:让知识的接入过程、索引状态与检索证据,被人看得懂、查得到、管得住。
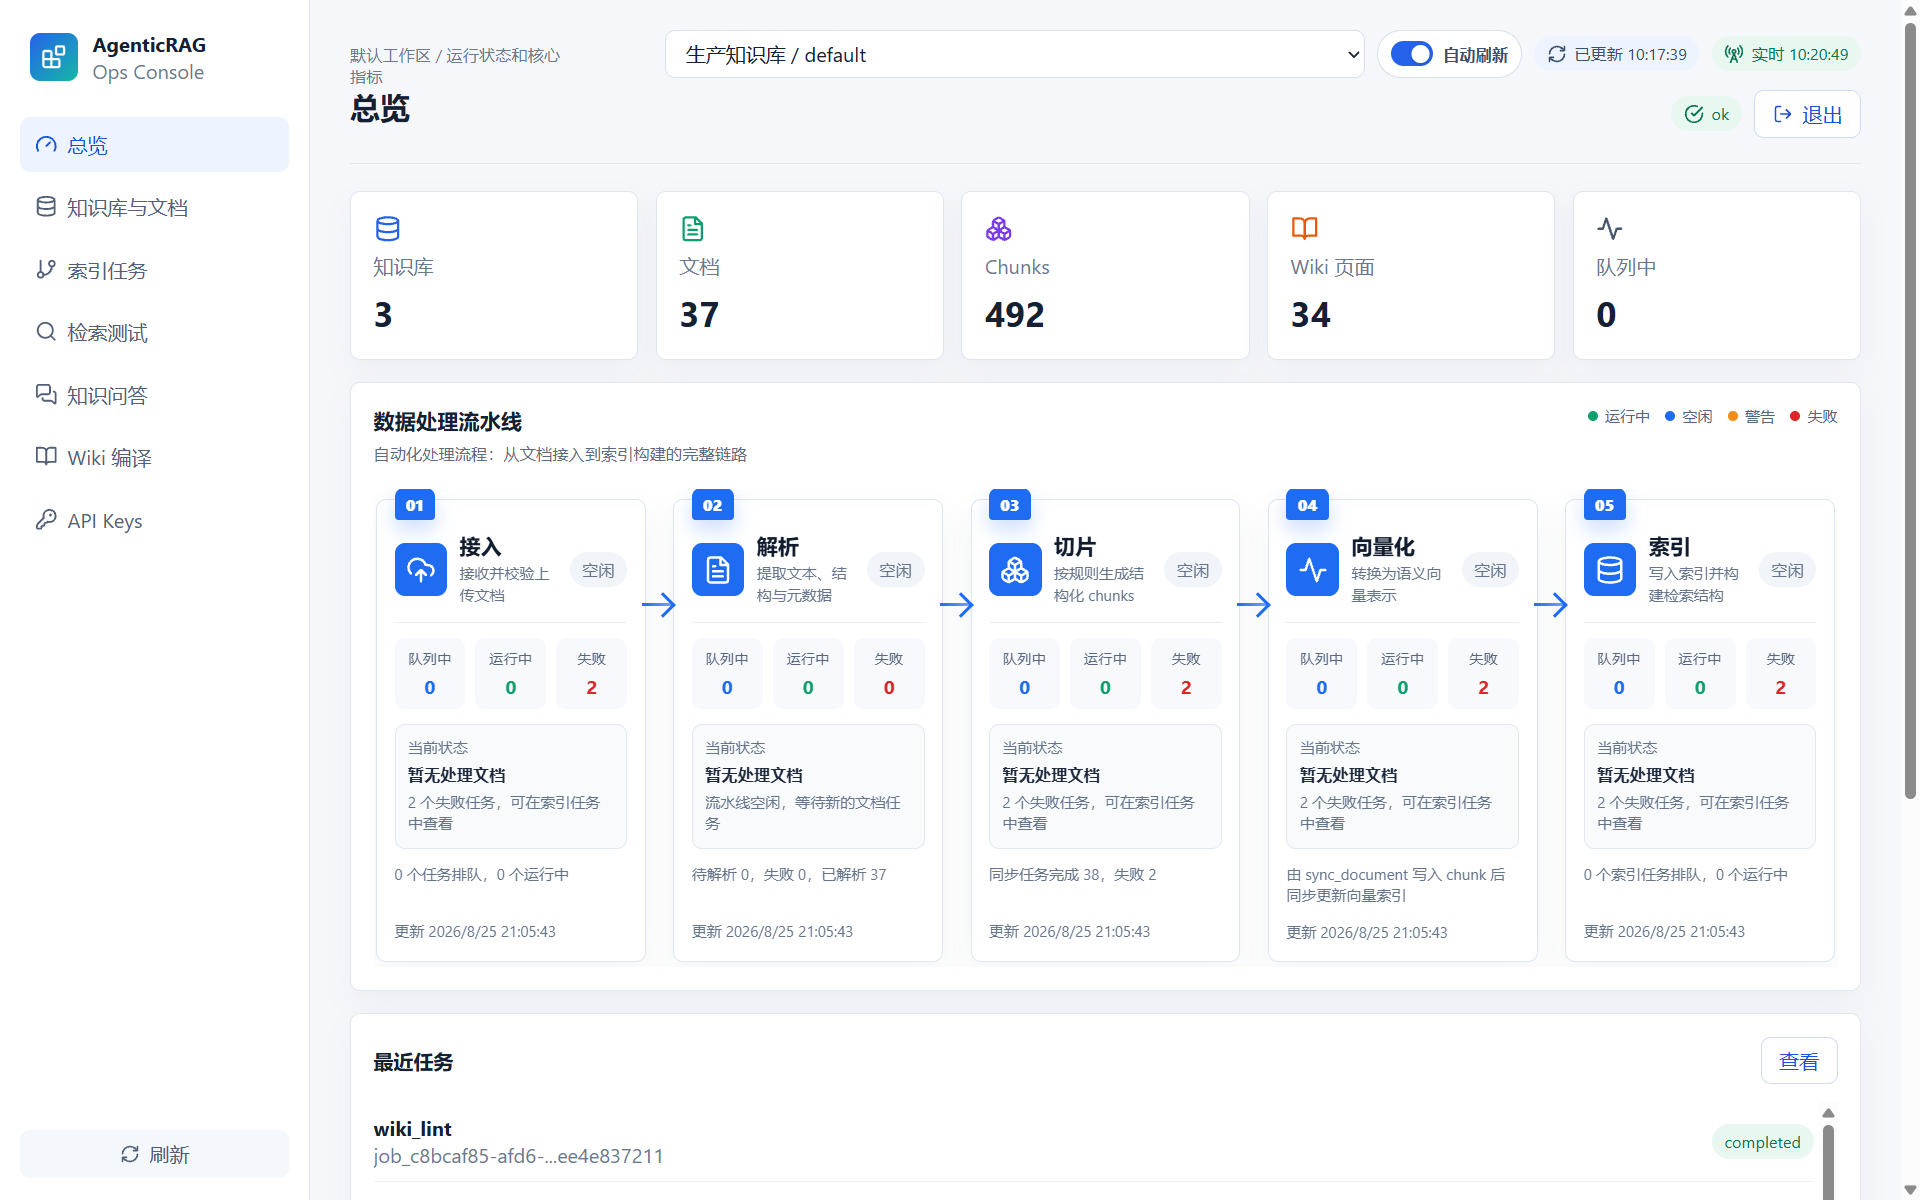
登录即见的知识控制台。知识库数量、文档总量、Chunks 规模与 Wiki 页面数聚合为一张实时态势图,数据处理流水线的五个环节各自暴露队列与失败计数。
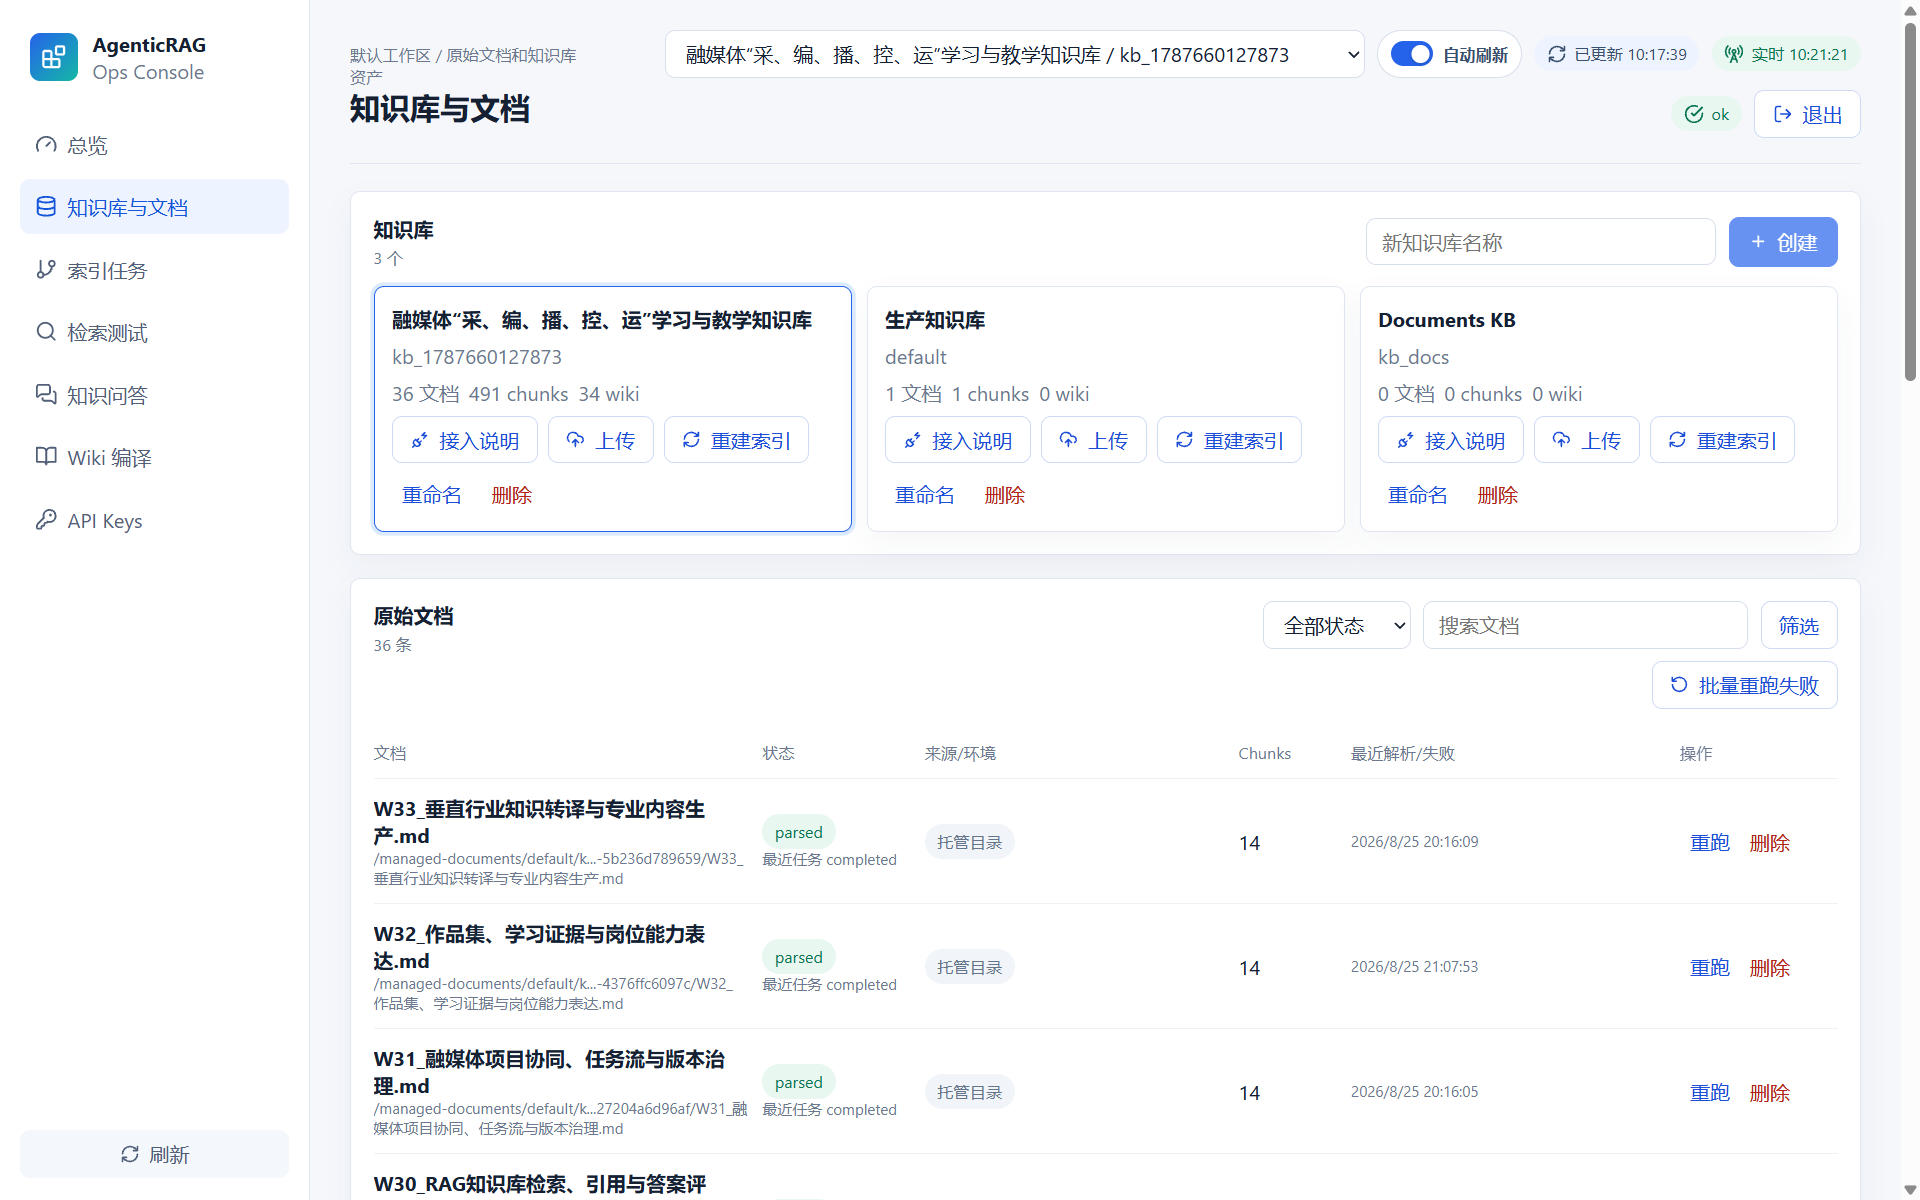
从知识库创建到原文档管理,一站式完成资料接入。每个知识库独立呈现文档数、Chunks 与 Wiki 统计,支持接入说明、上传资料与重建索引。
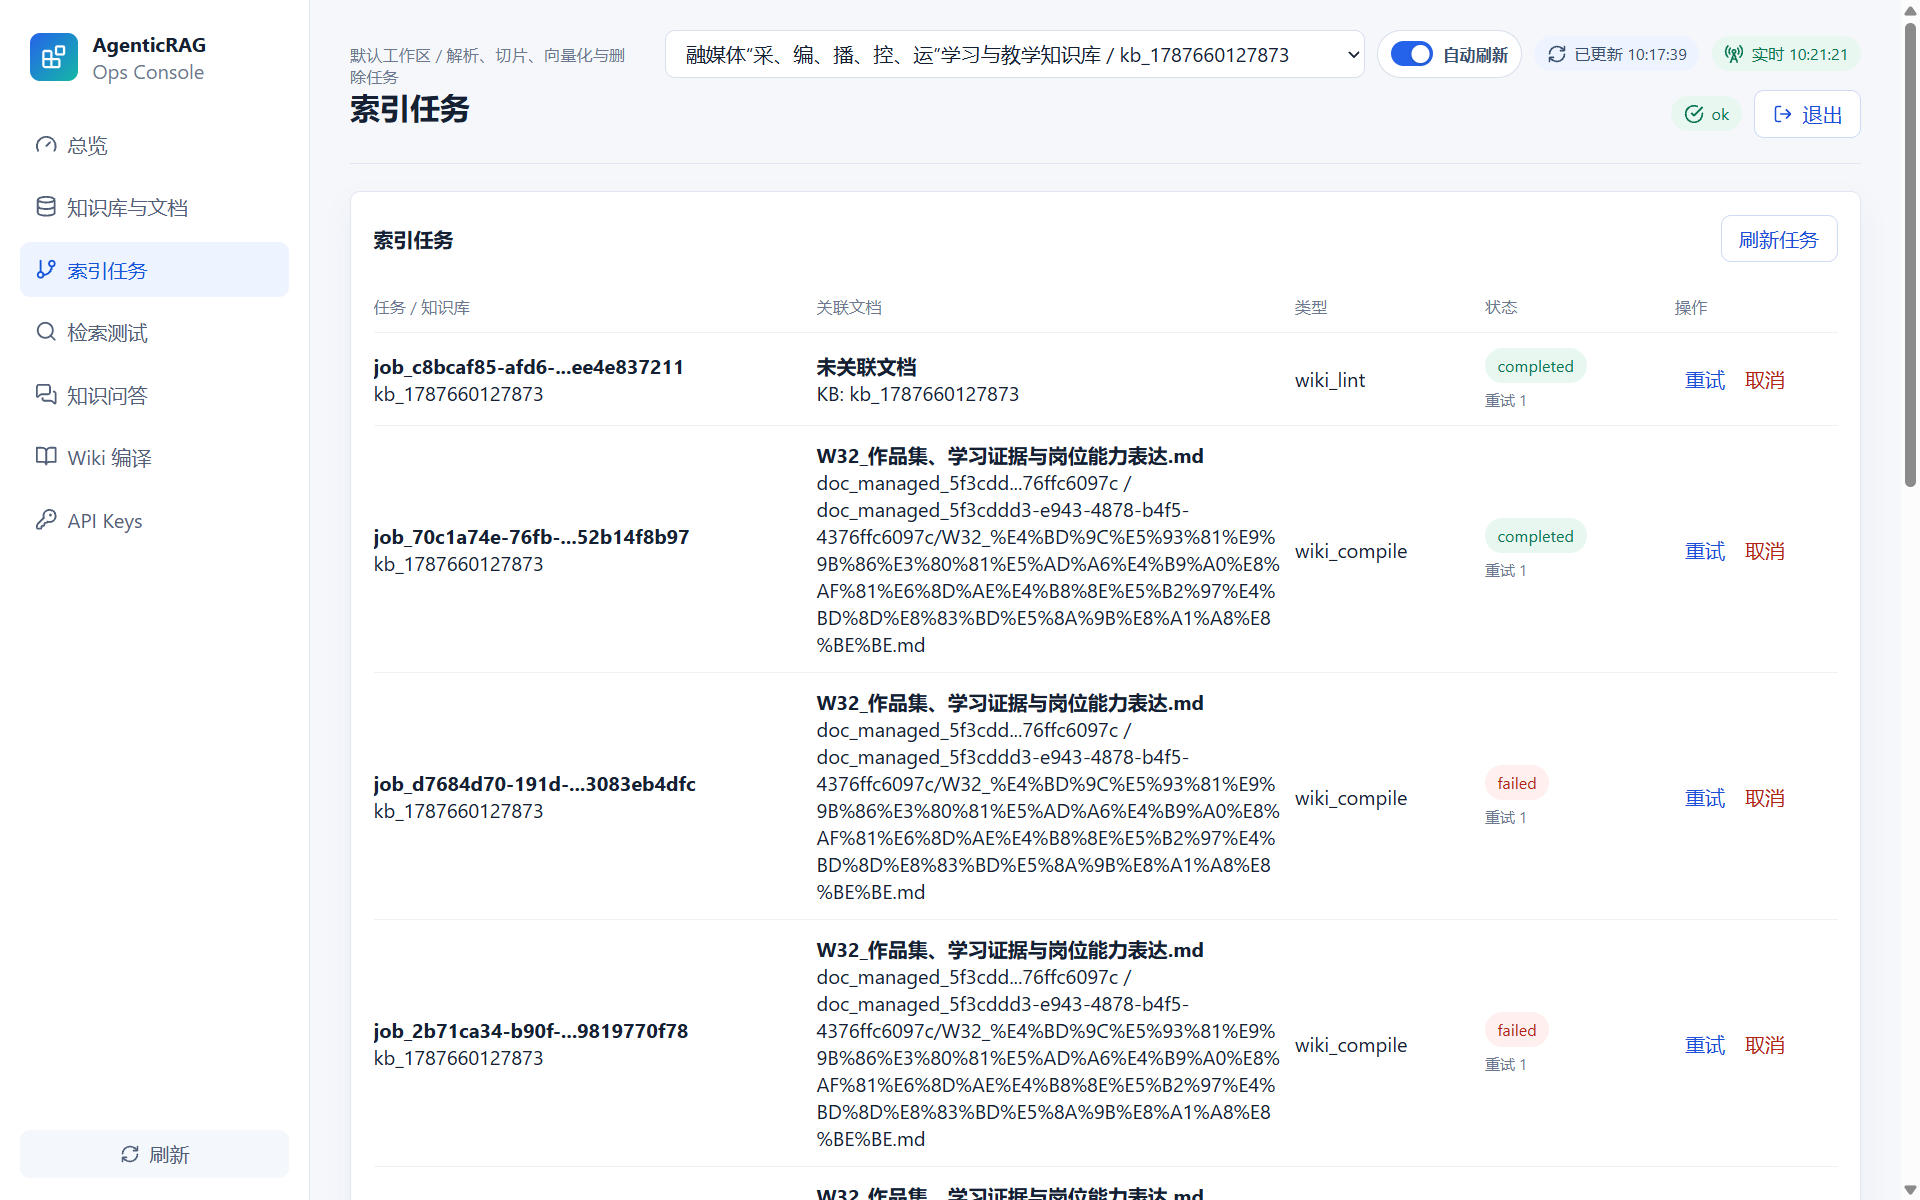
全局视角监控解析、切片、向量化与编译任务。Job ID、关联文档、任务类型与状态同屏呈现,失败的作业可直接重试,无需回到命令行排查。
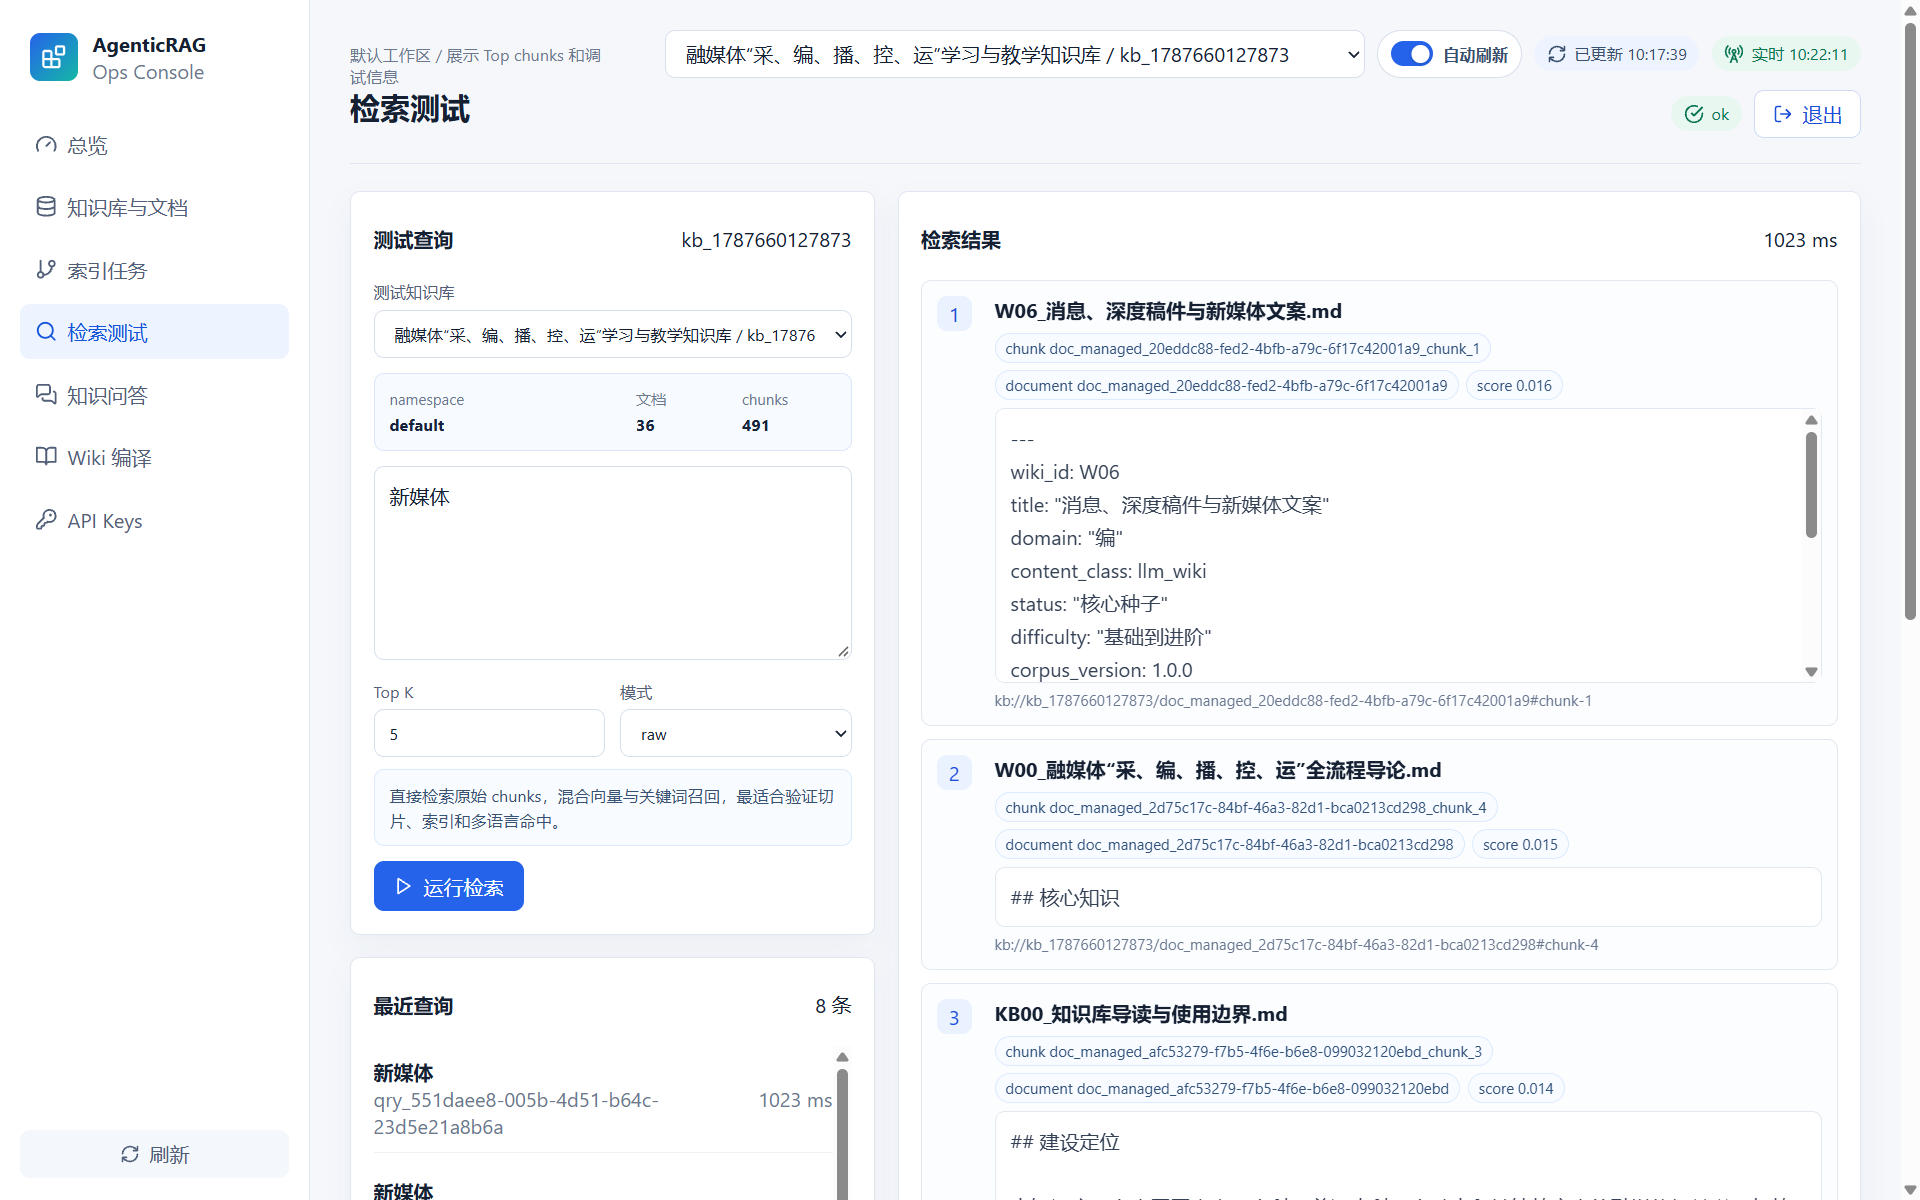
调整检索策略的沙盒。输入查询后直接看到 Top chunks 与命中耗时,每条结果展开 chunk、document、score 与 Wiki 元数据,方便快速验证切片质量。
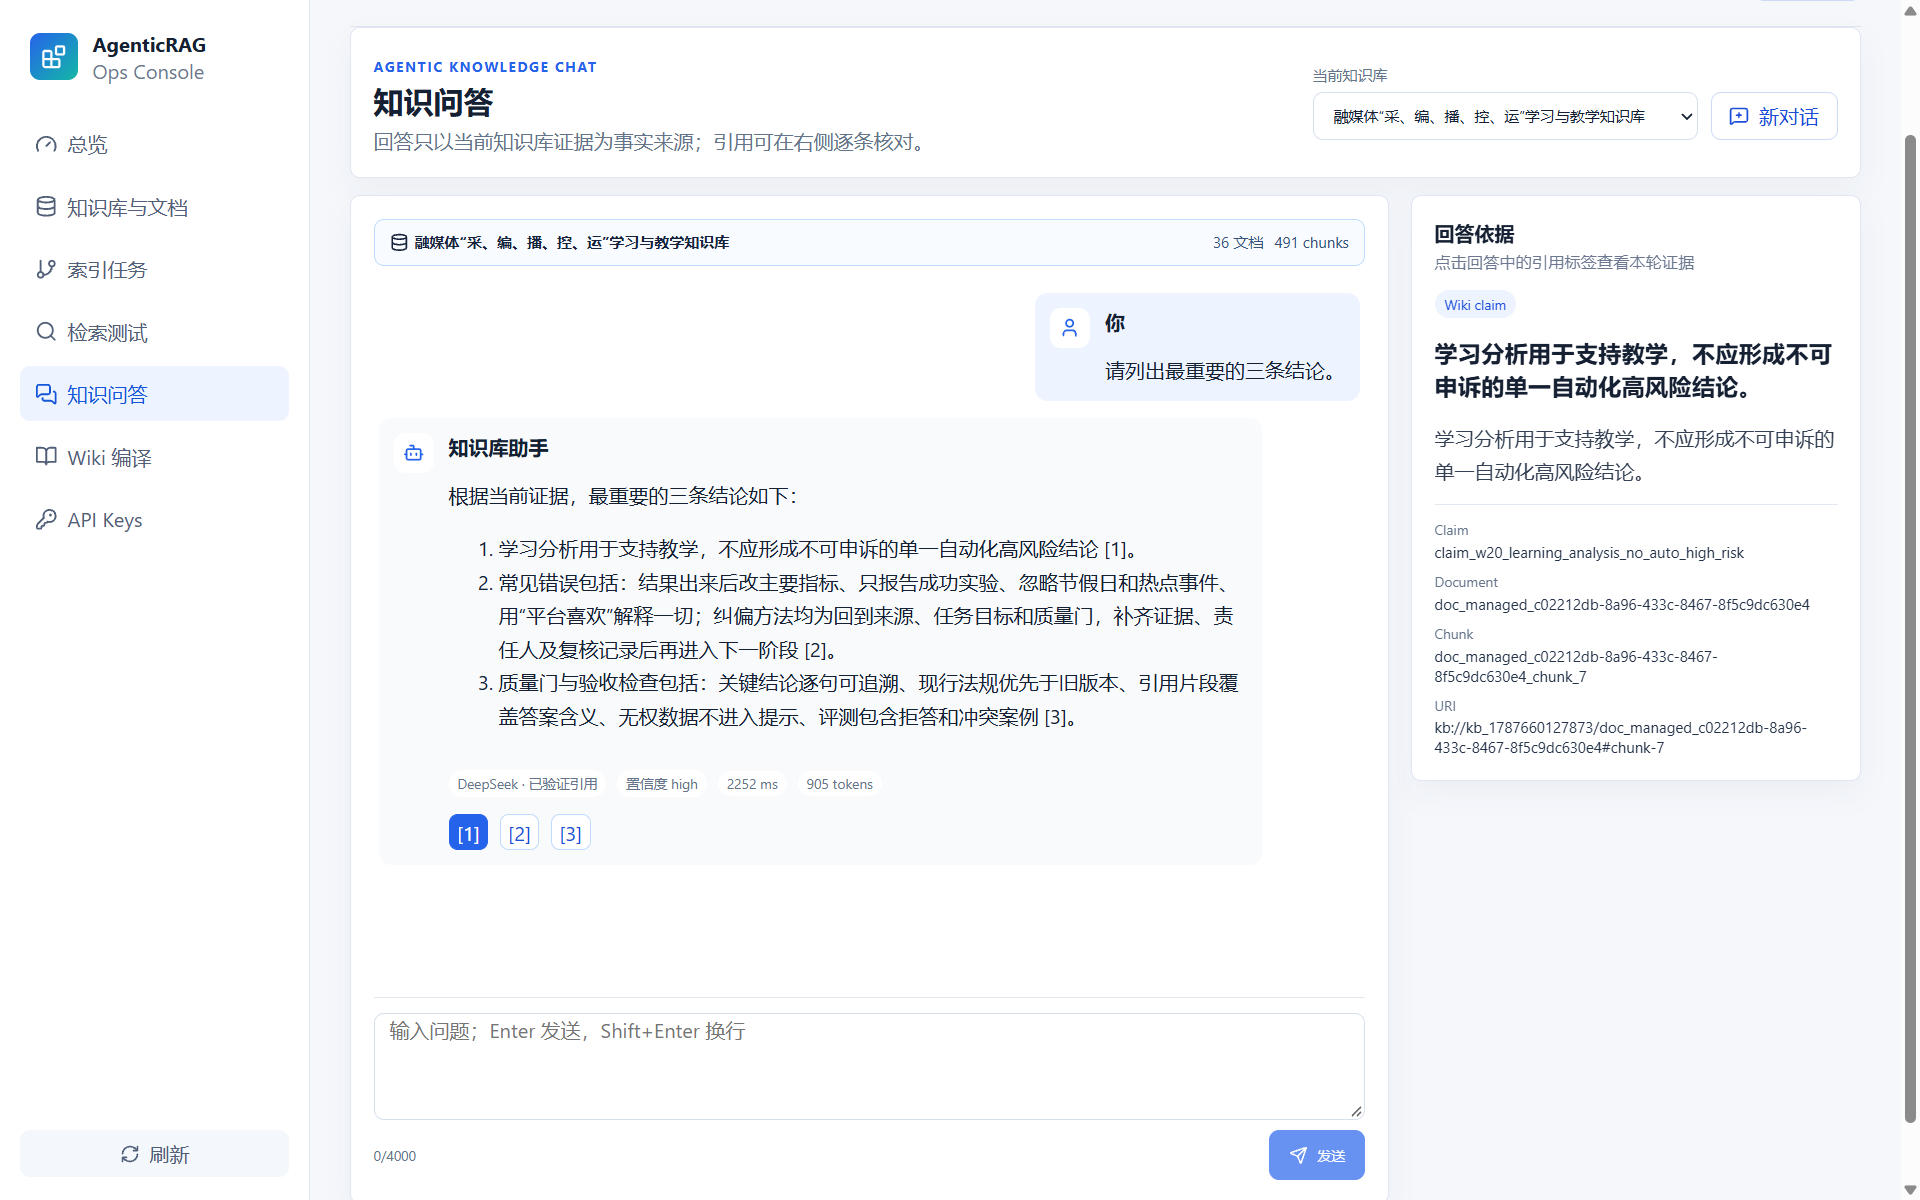
回答只以当前知识库证据为事实来源。左侧对话与右侧「回答依据」并排呈现,回答中的每一个引用标记都能在右侧定位到对应的 Wiki claim 与 chunk。
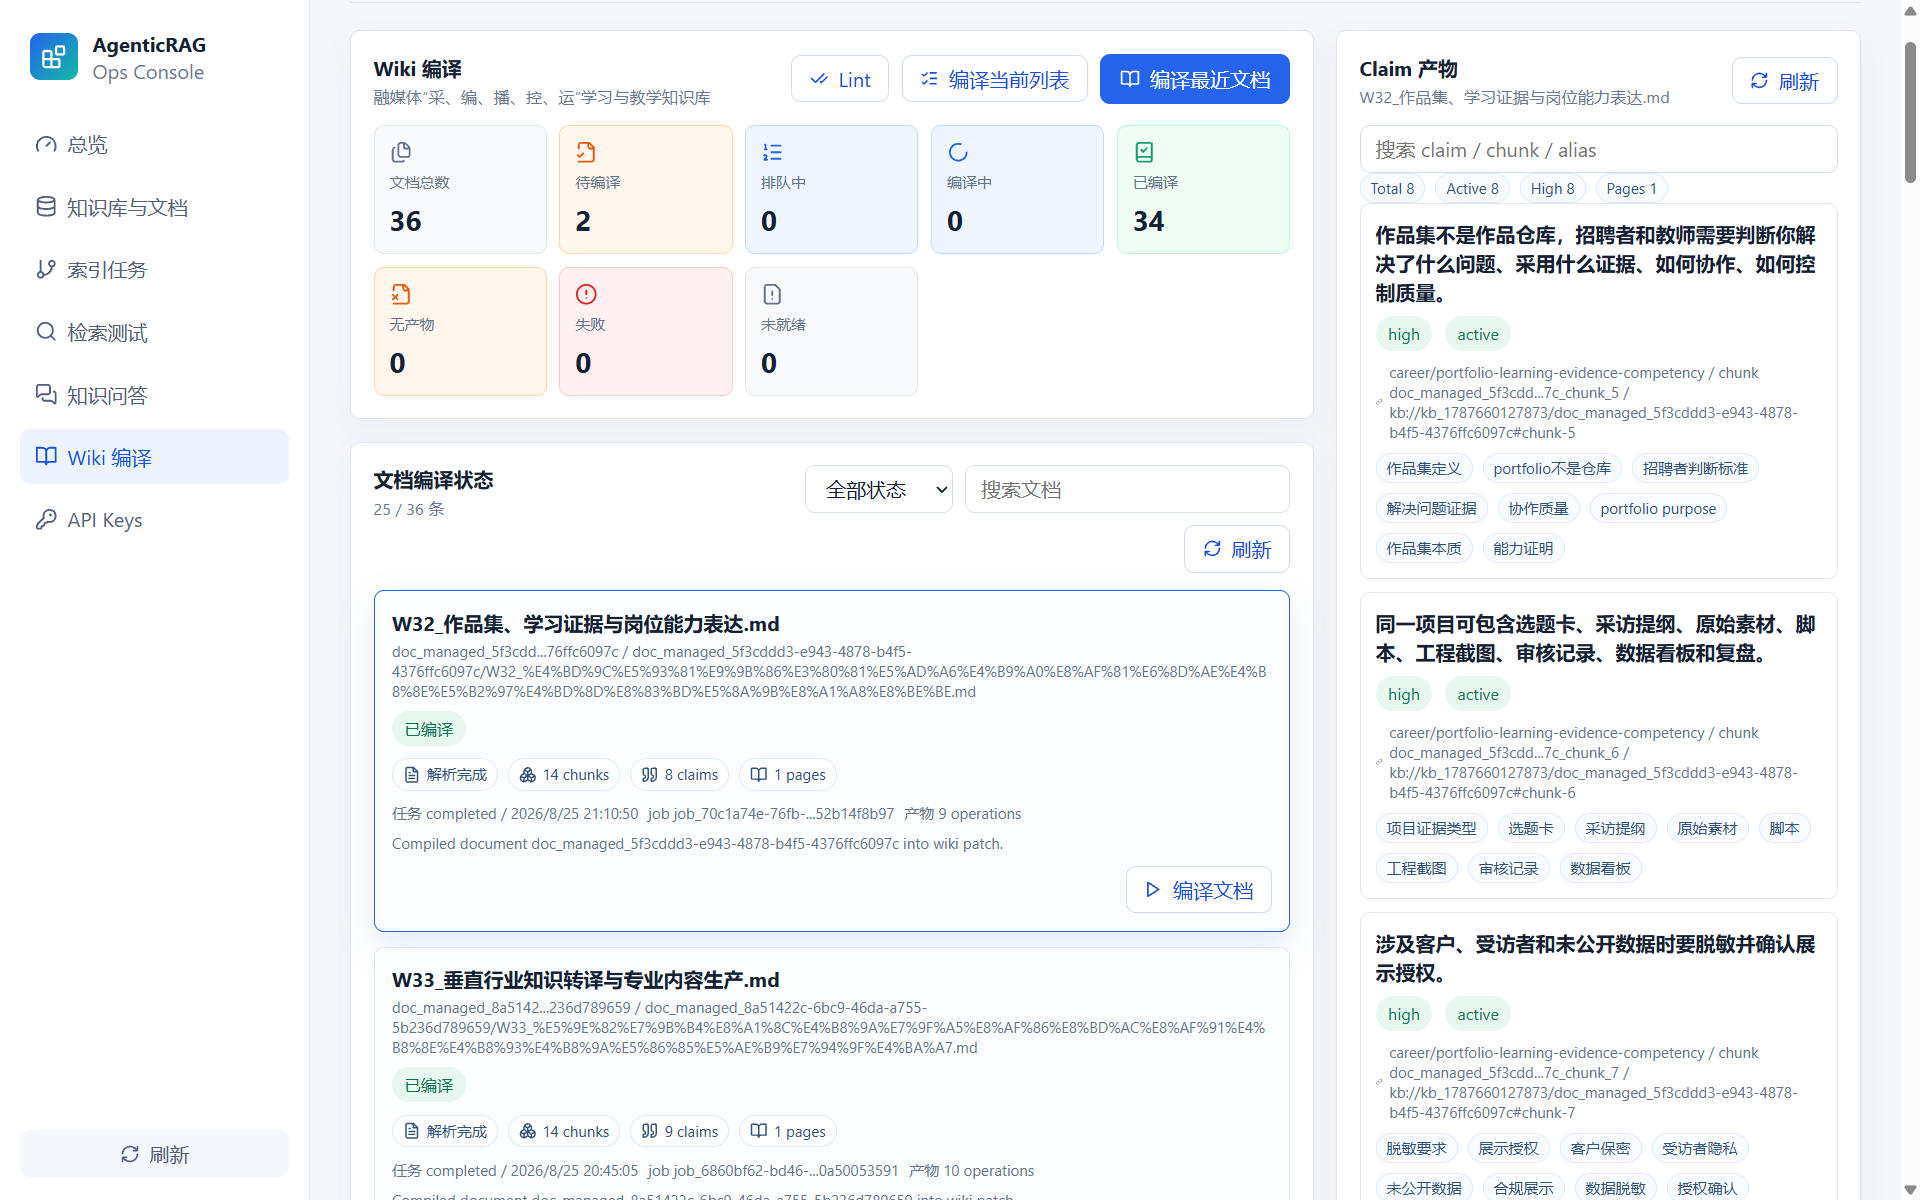
Agentic 模式下的核心能力。来源材料被编译为持久化 Wiki 页面与 Claims,左侧呈现编译进度与逐文档状态,右侧展示每条 Claim 的产物与关键词。
AgenticRAG 既能把资料编译为持久化的 Wiki 与 Claims,也能把命中结果直接组装为 evidence
cards。
前者适合需要长期维护的知识结构,后者适合即取即用的问答与工具调用。
把来源材料编译为持久化 Wiki 页面与 Claims,检索时直接命中已编译的知识单元,答案结构稳定、可复用、可维护。
由 Agent 根据问题自主决定检索路径,可跨文档关联、按主题聚合,适合复杂问题与多跳推理场景。
把持续增长的资料组织为可维护的知识结构,支持跨文档关联与主题聚合,让知识资产随使用不断厚实。
可按场景扩展图片、视频及融合检索,把多模态资料一并纳入同一套索引与证据体系。
项目采用 API 与 Worker 解耦架构。后端基于 Node.js 22、TypeScript 与 Fastify;PostgreSQL 负责元数据、任务、日志与关键词索引,Qdrant 承担向量检索,MarkItDown MCP 负责解析;Embedding 可接入云端兼容接口或本地 vLLM。
同一套知识底座,支撑完全不同的行业语义。AgenticRAG 可作为行业知识库、智能客服、研发检索、医疗文献、制造业资料、售后支持和智能体平台的通用底座。
把分散的行业资料统一接入,编译为可维护的 Wiki 结构与可引用证据,支撑长期运营的知识资产。
客服话术、产品手册与工单历史统一检索,每条回复都附带出处,减少答非所问与口径不一致。
设计文档、接口说明与历史决策集中检索,让新人快速理解上下文,让老问题不再重复讨论。
临床指南与文献资料统一入库,检索结果保留来源与元数据,为专业判断提供可核查的依据。
设备手册、工艺参数与检修记录沉淀为可复用技能,把老师傅的经验变成组织可检索的资产。
故障知识库与解决方案统一检索,一线人员拿到带出处的处置建议,缩短定位与响应时间。
作为智能体平台的通用知识底座,同一套基础设施服务多个 Agent、业务系统与知识库。
凡是可以被拆解为「资料接入 → 索引构建 → 证据返回」的业务,都可以接入同一套知识底座。
开放接口可以缩短集成周期,可信证据可以提升应用质量与客户信任。
上层 Agent 拿到结果后可据此组织回答、标注引用、回溯原文或继续调用工具,从而降低幻觉风险,提高业务可信度。
而是把知识的接入、编译与取证,提升为可验证的基础设施——证据优先、开放可替换、工程可验证、能力可复用。
结果以 evidence cards 返回来源、正文、分数、Metadata 与知识单元标识。上层 Agent 可据此组织回答、标注引用、回溯原文,从源头降低幻觉风险。
Embedding、LLM、向量库和解析服务均采用模块化接口,可按成本、算力和数据安全要求选择云端或本地能力,减少供应商锁定。
功能、性能、健康和恢复流程都有明确证据。Worker 支持任务恢复、自动重试与并发配置;API Key、租户过滤、健康检查与索引状态检查为长期运行提供保障。
同一底座可服务多个 Agent、业务系统和知识库。文件新增、更新和删除可触发增量同步,减少全量重建成本,让知识资产持续在线。
同一套核心能力,两种交付形态。先在控制台跑通知识接入与效果验证,再按需平滑迁移至内网环境。